
Sua fatura de LLM chega como um simples número. Um valor agregado por conta, no fim do mês, sem identificar qual time gastou, qual aplicação disparou o consumo ou qual agente de IA entrou em loop depois do deploy de sexta-feira. Você sabe quanto custou, mas não sabe de quem é a conta.
Na disciplina de FinOps de cloud providers, esse problema foi resolvido há tempos com o uso de tags, onde cada recurso computacional carrega consigo um rótulo de centro de custo, e o rateio sai naturalmente pelo próprio provedor. Em GenAI isso não funciona, por um motivo estrutural: não existe recurso para rotular. Existe uma chamada HTTP efêmera, que nasce e morre em segundos, consome uma quantidade de tokens que ninguém previu e não deixa nenhum objeto persistente para trás.
A unidade de custo de AI FinOps não é o recurso: é a requisição. E o único lugar por onde toda requisição passa por completo, com a informação do modelo escolhido, a contagem de tokens, a identidade de quem chamou e a latência de resposta, é o seu AI Gateway.
Este artigo mostra, de forma prática, como o Sensedia AI Gateway (como camada central de governança) consegue transformar isso em uma disciplina financeira completa, ao medir, precificar, atribuir e governar o seu gasto com IA.
Quatro camadas de AI FinOps
Antes de métricas e dashboards visuais, vale fixarmos o modelo mental. AI FinOps se sustenta em quatro camadas, e a ordem entre elas não é uma escolha arbitrária.
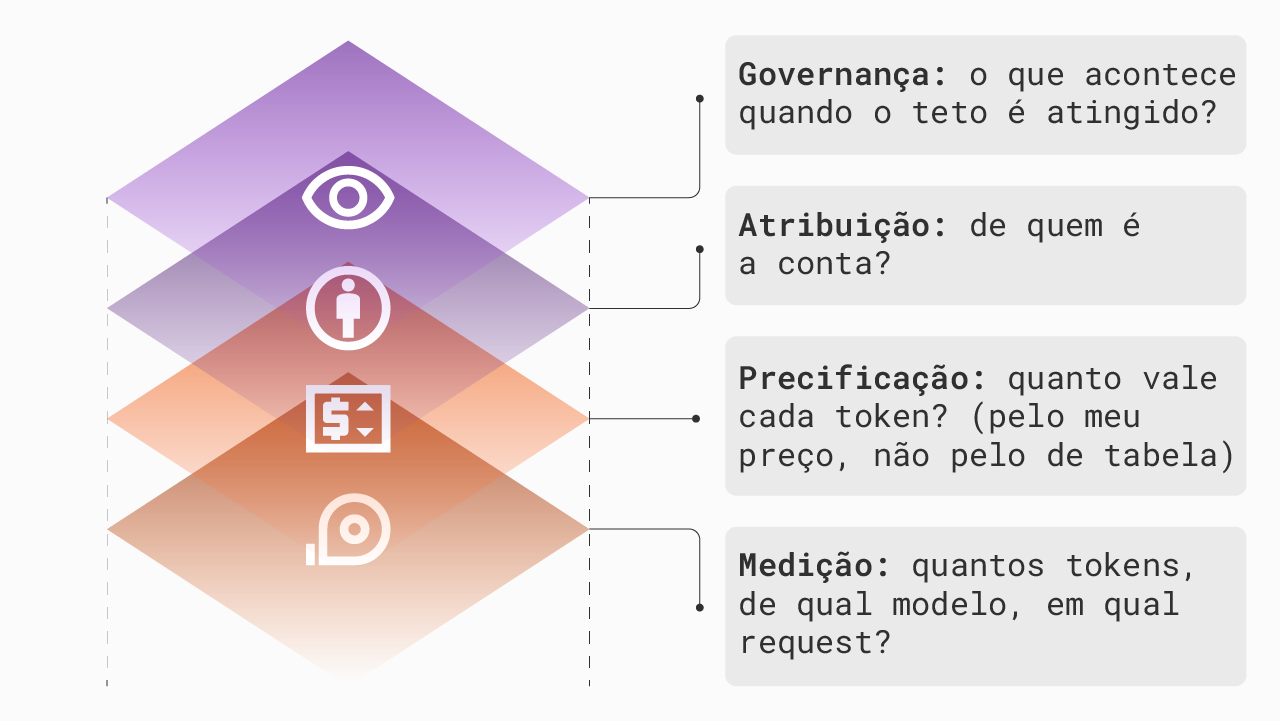
Cada camada só existe se a anterior existir. Chargeback sem seu preço negociado devidamente configurado é uma ficção contábil: você rateia entre os times um custo que não é o que a sua empresa paga. Budget sem custo em tempo real vira um mero alerta post mortem: você só descobre o estouro do orçamento depois que ele aconteceu. Iniciativas de FinOps que começam pela camada de cima, com um relatório bonito de rateio sobre uma fundação que não existe, tendem a travar com mais facilidade. A Sensedia preferiu construir isso de baixo para cima.
Camada 1 de AI FinOps: Medição
O custo precisa nascer no data plane
A primeira decisão de arquitetura do Sensedia AI Gateway também é a mais determinante: o custo é calculado no data plane, a cada request. Não existe um job agendado que lê a fatura do provider, ou uma reconciliação em lote contra um CSV de billing.
Quando uma requisição de LLM atravessa nosso Gateway, o data plane resolve o par provider + modelo, consulta o catálogo de preços vigente para aquele par (considerando possíveis preços customizados cadastrados pelo próprio cliente), e emite o custo em moeda (USD) junto com a própria telemetria da requisição. O custo vira um atributo da requisição, disponível no mesmo instante em que ela termina e vira telemetria.
Isso parece um mero detalhe de implementação, mas não é. É justamente o que torna as camadas 3 e 4 possíveis: você não consegue bloquear um estouro de orçamento com um dado que só chega no fechamento do mês. Rate limit por custo em tempo real obviamente exige custo em tempo real. E o custo em tempo real exige que o cálculo seja feito no caminho da requisição.
O que a telemetria carrega
O custo é emitido como métrica acumulada e como atributo do trace da chamada, sempre acompanhado das dimensões que permitem cortá-lo para futuros relatórios. Por exemplo:
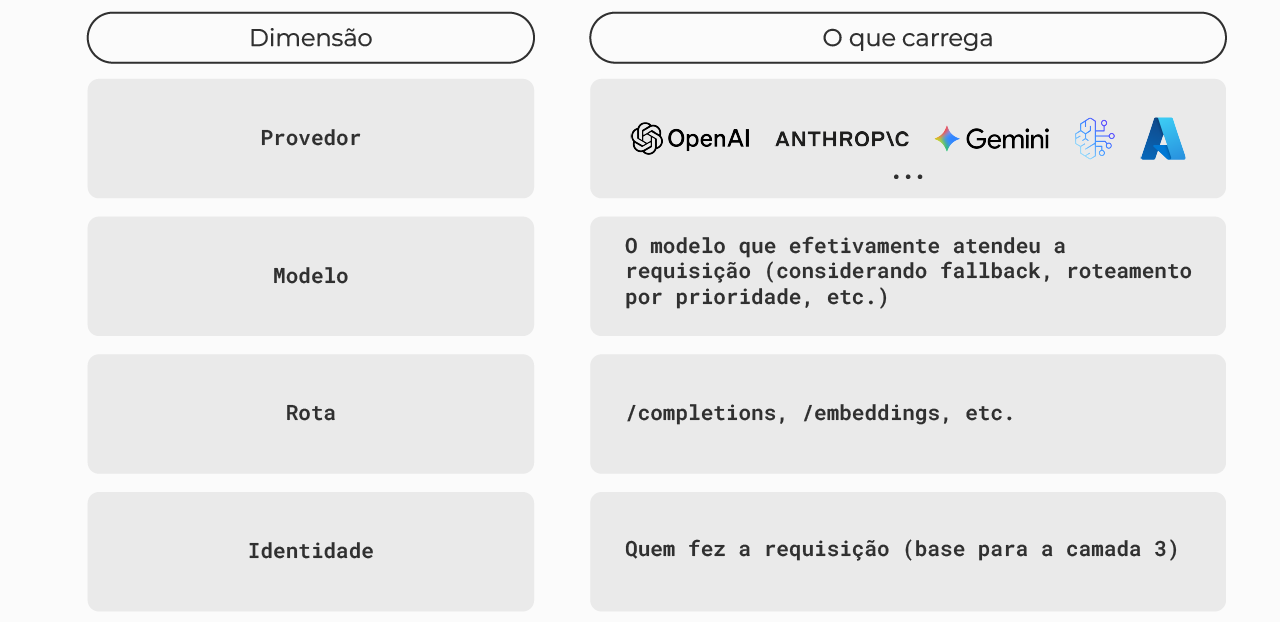
E o consumo de tokens não é somente um número. Ele é separado em quatro tipos: input, output, leitura de cache e escrita de cache, pois cada um tem preços diferentes. Essa separação é importante, pois ela é a responsável por transformar o cache de uma simples métrica de performance em uma métrica financeira, como veremos no showback.
Camada 2 de AI FinOps: Precificação
Preço de tabela não é o seu preço
A maior parte das ferramentas de mercado calcula custo com o preço público do LLM provider. Funciona como estimativa, mas não como base de rateio interno. Empresas de grande porte não pagam preço de tabela. Geralmente existem descontos por volume, contratos enterprise, ou condições especiais negociadas por modelo. Empresas que optam por modelos open-weight em infraestrutura própria também precisam de uma forma customizada de configurar esse preço.
Se o valor que você rateia entre seus times não é o que a sua empresa paga, o chargeback perde legitimidade logo no primeiro questionamento. O Sensedia AI Gateway resolve isso com um catálogo de preços em camadas.
Conteúdo relacionado: Como um AI Gateway facilita o uso de múltiplos LLMs nas empresas?
Base pública com sobrescrita do cliente
A camada de base vem de uma fonte pública de preços de mercado, atualizada por um ciclo de refresh. Sobre essa base, você pode definir suas próprias tarifas, e a sobrescrita é aditiva: você sobrescreve o preço do GPT-4o sem tocar nas outras centenas de modelos do catálogo público. Cada preço da lista exibe sua origem a partir das camadas existentes:
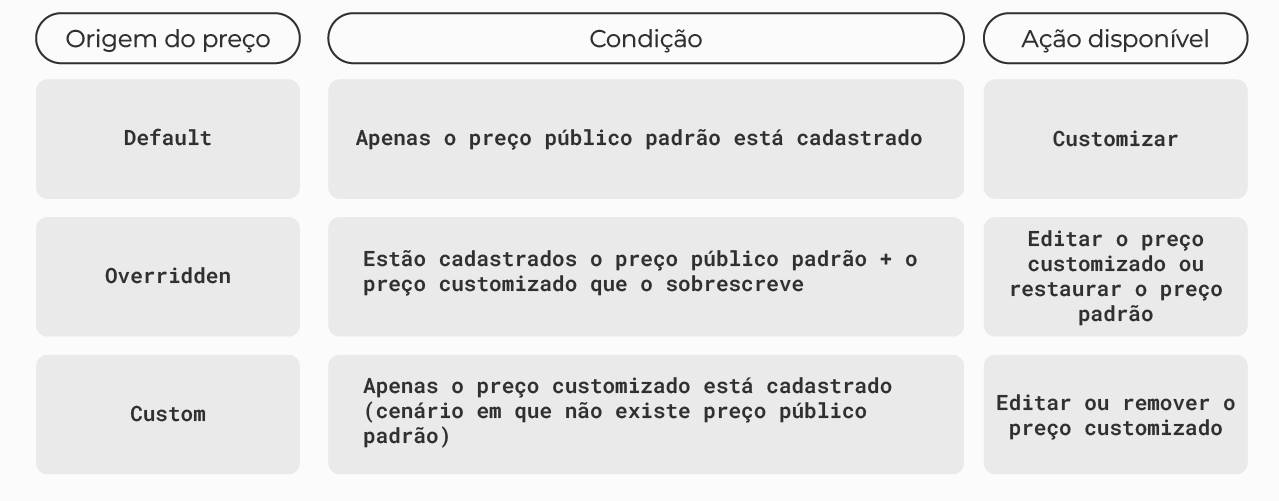
O termo é Overridden, não Replaced, e essa escolha reflete o comportamento: o preço padrão é preservado, não apagado. Ao abrir o detalhe de um preço sobrescrito, a sua tarifa e a de mercado aparecem lado a lado (o que já é, por si só, um dado de negociação). E, ao remover um preço Overridden, o sistema volta ao preço padrão em vez de deixar o modelo órfão.
Duas decisões que importam
Existem dois comportamentos que costumam passar despercebidos e que são importantes para quem opera em setor regulado:
- Alteração de preço não é retroativa. Mudar, restaurar ou remover um preço vale para o consumo futuro. O custo histórico já apurado não é recalculado, pois isso é fato histórico, registrado sob a tabela de preços que vigorava naquele momento. Se ele fosse uma visão recalculável, o relatório de um mês mudaria no mês seguinte, o que atrapalharia qualquer fechamento contábil.
- Modelo sem preço ativo não emite telemetria com custo zero. Se um modelo não tem preço definido no catálogo, seu consumo é contabilizado normalmente em tokens e excluído do custo em moeda. Isso acontece porque, no nosso entendimento, custo não apurado é diferente de custo zero. Um sistema que silenciosamente soma zero ao total produz um relatório que fecha e parece correto, mas está essencialmente errado.
O que as duas primeiras camadas produzem
Showback
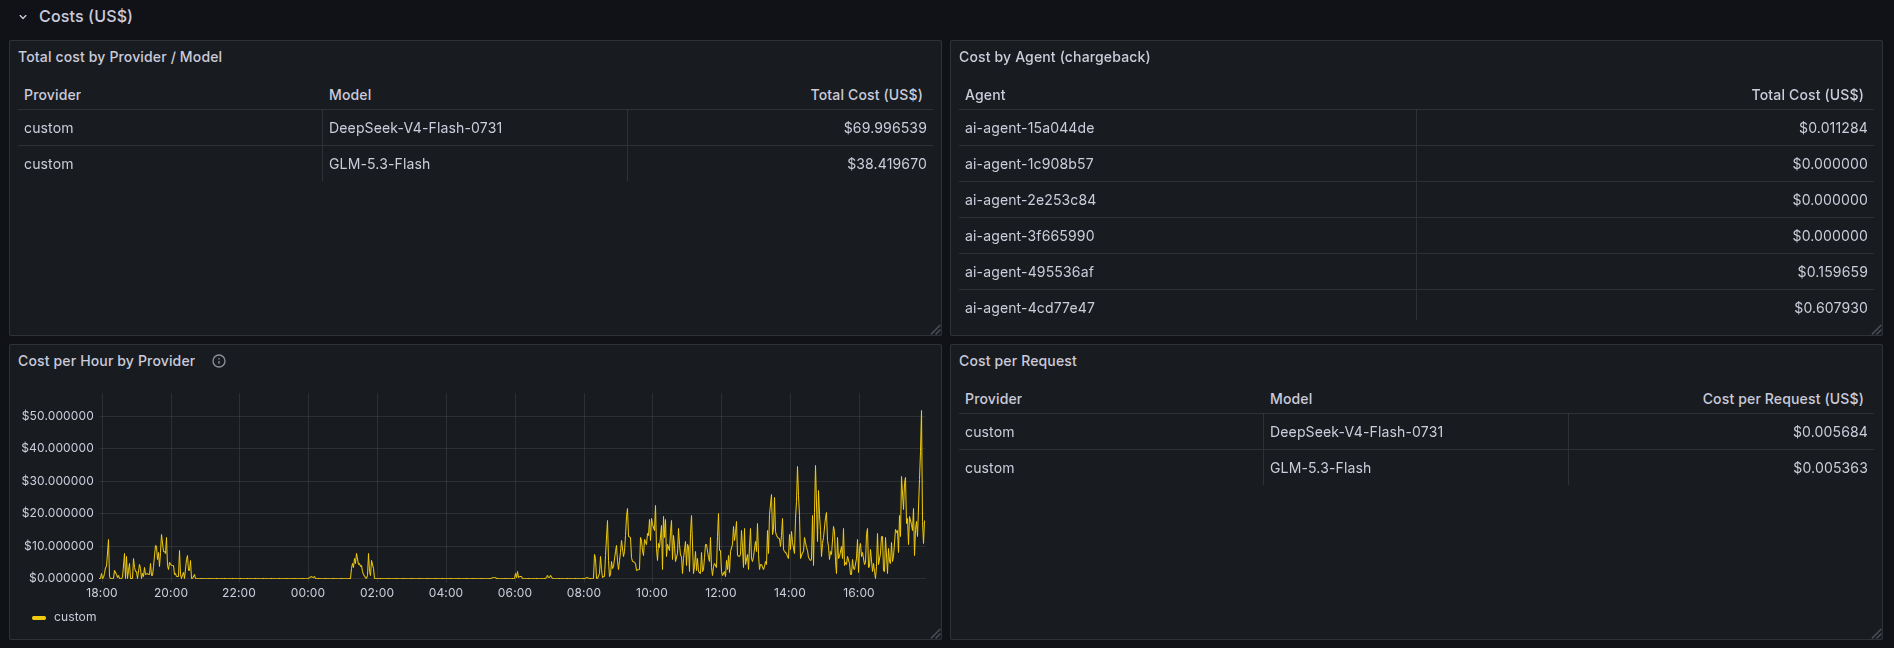
Com o custo medido e precificado corretamente e com as devidas dimensões implementadas nas visões, o showback é mera consequência. Os dashboards de custo do Sensedia AI Gateway quebram o custo por provider, modelo e agente de IA, com evolução temporal e visão dos maiores consumidores. O que separa showback de um simples “gráfico de consumo” são os detalhes a seguir.
Economia unitária
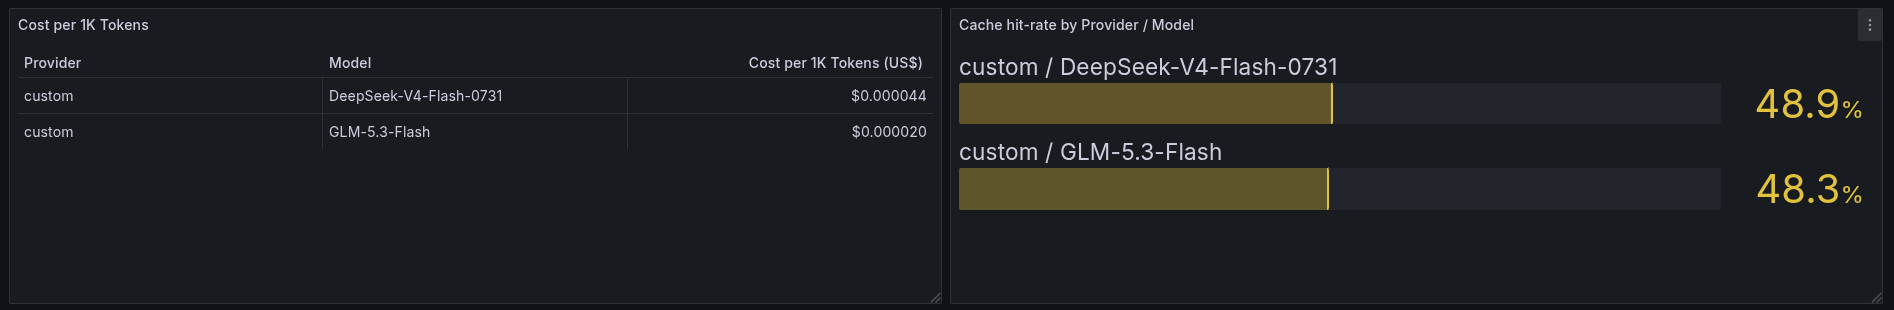
Dois indicadores mudam a conversa: custo por requisição e custo por 1000 tokens. Eles respondem a pergunta que o gráfico de custo total não responde: meu agente ficou mais caro ou só ficou mais usado?
São perguntas com respostas opostas. Crescimento de custo total que mantém o custo por requisição estável é um sinal de adoção, e é uma boa notícia, que provavelmente merece mais orçamento. Já o aumento do custo por requisição com volume estável é um sinal de possível degradação: prompt inchando, contexto crescendo a cada iteração, retry silencioso, alguém que trocou o modelo sem avisar.
Sem economia unitária, os dois casos aparecem no dashboard como a mesma linha subindo. Os dois indicadores saem do cruzamento das séries que a camada 1 emite: o custo do período dividido pelo número de requisições, e o custo do período dividido pelo total de tokens em milhares. Nenhum deles exige instrumentar a aplicação, pois o AI Gateway já tem as duas metades.
Cache hit-rate como métrica financeira
Voltando à separação dos quatro tipos de token da camada 1. Como a leitura de cache é precificada à parte, e por uma fração do preço do input normal, o cache hit-rate deixa de ser um indicador de performance e passa a ser uma alavanca direta para a redução de custo.
A conta é a proporção entre os tokens lidos do cache e o total de tokens de entrada. Quanto maior esse número, menor o custo por request, sem demandar qualquer mudança de modelo. Uma equipe que reestrutura seus prompts para maximizar o prefixo cacheável não está fazendo só otimização de latência: está também reduzindo a fatura, e agora ela tem o número para provar.
Custo e performance na mesma tela
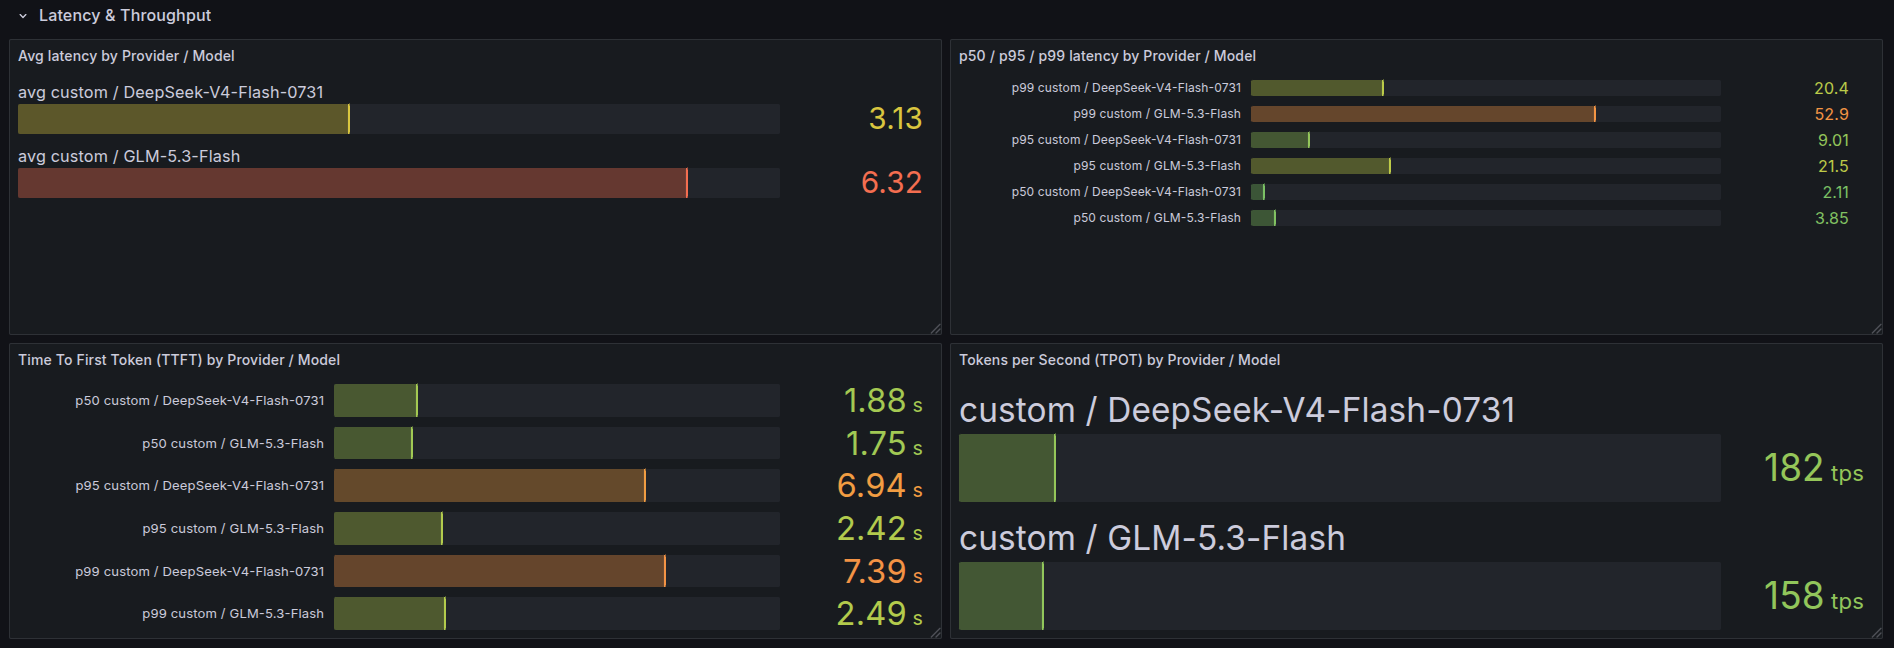
Os painéis de custo convivem lado a lado com métricas como TTFT (Time to First Token), tokens por segundo e percentis de latência. Não só por conveniência de layout, mas porque toda decisão de custo em IA é um trade-off com qualidade ou latência. Trocar um modelo por um mais barato é uma decisão de duas variáveis. Ver as duas no mesmo lugar é o que permite tomá-la com dado em vez de opinião.
A seguir, você pode conferir algumas das métricas observadas com o Sensedia AI Gateway:
Camada 3 de AI FinOps: Atribuição
A identidade é o contrato
A diferença entre showback e chargeback não é somente o relatório, mas também a dimensão da atribuição. Showback mostra que a sua plataforma de IA gastou 40 mil dólares. Chargeback diz que 12 mil são do time de atendimento, 10 mil do time de vendas e 18 mil de marketing, lançando isso no orçamento de cada um. Para que isso seja alcançado, você precisa de um atributo estável, presente em cada requisição, que diga de qual área aquela chamada veio.
Claims do JWT
O Sensedia AI Gateway usa claims do JWT como dimensões de rateio. O cliente pode carregar no token JWT a área, o projeto ou o time, e o Gateway divide as métricas de custo de acordo com essa claim configurada. Essa foi uma decisão de arquitetura, e vale deixar mais claro qual é a alternativa que ela descarta.
O caminho mais comum no mercado é o uso de uma virtual key: uma chave de API por time, emitida pelo Gateway, com o rateio derivado a partir de qual chave foi usada. É simples de começar, e termina em API key sprawl: um cadastro paralelo de chaves para manter em sincronia com o IdP da empresa, que se desatualiza na primeira reorganização, fusão de squads ou pessoa que muda de área. A granularidade do rateio passa a ser limitada pela sua disciplina com a gestão de chaves.
Ao amarrar a atribuição ao token que o seu IdP já emite, o rateio segue o organograma automaticamente. A área correta chega em cada requisição porque ela naturalmente já está lá, e não porque alguém lembrou de atualizar uma planilha de chaves.
Como tudo em arquitetura é sobre trade-offs, essa escolha obviamente exige mais configuração inicial e carrega uma responsabilidade compartilhada, pois cabe ao cliente Sensedia garantir que as claims corretas estejam no token e configuradas na plataforma. Em troca, ela exige muito menos manutenção no longo prazo, e o dado de rateio herda a governança de identidade que a empresa já tem.
Camada 4 de AI FinOps: Governança
Por que rate limit não protege orçamento?
Todo API Gateway tradicional sabe limitar requisições por minuto. É uma das políticas mais antigas da categoria, mas ela não serve para o orçamento de IA, e o motivo é aritmético. Mil requisições podem custar 2 ou 2000 dólares, dependendo do modelo escolhido, do tamanho do contexto enviado e de quantos tokens a resposta gerou. Um limite que se baseia somente em requisições não é um limite de orçamento, é um limite de tráfego (que pode até se comportar como orçamento enquanto o padrão de uso não muda). No entanto, sabemos que o padrão de uso de IA muda toda semana.
Logo, só um limite baseado em custo de fato é um limite de orçamento. O Sensedia AI Gateway permite definir tetos de custo por rota com rate limit medido em dólares, e não somente em chamadas. Ao atingir o teto definido, a ação de enforcement configurada entra em vigor.
Por que no AI Gateway, e não no sistema de billing?
A pergunta é justa: o financeiro já não controla o orçamento? No fechamento, sim. O sistema de billing sabe do estouro depois que ele aconteceu. O Gateway sabe já no momento da resposta para cada requisição, porque é ele que calcula o custo (camada 1) com o preço que você realmente paga (camada 2). Governança de custo de IA precisa acontecer no caminho da requisição, senão vira somente contabilidade.
Roteiro de adoção
Se você está começando, a ordem das camadas que apresentamos é o ponto de partida:
- Centralize seu tráfego de IA em um Gateway: sem uma camada central de governança, nada do resto existe. Consumo direto ao provider de LLM é um ponto cego que você carrega para sempre.
- Ligue a medição e utilize o preço padrão por algumas semanas: ter o número aproximado hoje vale mais do que ter o número exato daqui a um trimestre.
- Cadastre suas tarifas negociadas: é aqui que o número deixa de ser somente métrica e passa a ser base defensável de rateio.
- Publique o showback antes de cobrar de alguém: dê aos times um certo espaço de tempo para visualizar o próprio consumo. A conversa de chargeback fica muito mais fácil quando ninguém é pego de surpresa.
- Ative budgets nas rotas críticas: comece monitorando o consumo, e então bloqueando depois que os times já conhecem seus próprios padrões de consumo.
Conteúdo relacionado: Saiba como o AI Gateway já está sendo utilizado no mercado financeiro
Uma nota sobre reconciliação
Vale antecipar uma objeção de todo profissional de FinOps experiente: o custo apontado pelo AI Gateway não vai bater exatamente com a fatura do provider. Não vai, e nenhuma ferramenta faz isso. Cenários causados por retentativas, streamings abortados, diferenças de arredondamento e janelas de fechamento distintas podem sempre gerar alguma divergência.
O objetivo do custo monitorado no Gateway não é substituir a fatura, mas sim ajudar a explicá-la. A fatura diz quanto, e o Gateway diz de quem, em qual modelo, em qual aplicação e por quê. Uma divergência de fração percentual entre os dois é um ruído. Um número agregado sem atribuição nenhuma é um problema muito maior de gestão.
A escolha final é sobre a fricção
Os três cenários abaixo mudam o comportamento dos times de formas diferentes:
- Showback muda o comportamento por transparência: ninguém quer aparecer no topo da lista de maiores consumidores (pelo menos não sem um motivo defensável).
- Chargeback muda o comportamento por orçamento: o custo de AI passa a competir com as outras prioridades financeiras do time.
- Budget muda o comportamento por bloqueio: é uma camada de proteção, não a estratégia.
Escolha o grau de fricção que a sua organização suporta. Mas note que os três vão exigir exatamente a mesma fundação técnica que discutimos: custo real, calculado no caminho da requisição, com o preço que você de fato paga, atribuído a uma identidade que não se desatualiza.
É essa a fundação que a Sensedia entrega, possibilitando que a sua organização construa sua própria estratégia em cima da nossa plataforma. O resto é política interna, e essa é uma decisão sua.
Quer saber como habilitar a disciplina de FinOps no seu negócio? Converse agora com nossos especialistas!

Conteúdos relacionados
Confira os conteúdos produzidos pela nossa equipe
Sua história de sucesso começa aqui
Conte com nosso apoio para levar as melhores integrações para o seu negócio, com soluções e equipes profissionais que são referência no mercado.


